Tips Menjalankan LLM Offline dengan Perangkat Terbatas, Optimalkan Model AI agar Tidak Boros Memori
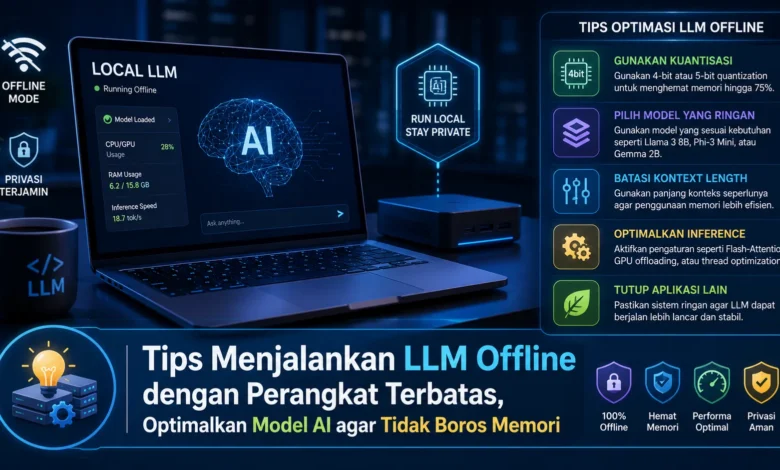
Menjalankan Large Language Model atau LLM secara offline kini tidak selalu membutuhkan komputer kelas workstation dengan RAM dan GPU berkapasitas besar. Laptop maupun PC dengan spesifikasi terbatas masih dapat digunakan selama model, format quantization, context window, dan runtime dipilih secara tepat. Dengan optimasi yang sesuai, TEKNOLOGI AI lokal dapat dimanfaatkan untuk menulis, merangkum, membantu pemrograman, atau memproses dokumen secara lebih privat tanpa membuat penggunaan RAM dan VRAM membengkak.
Sesuaikan LLM dengan Kapasitas RAM dan VRAM
Langkah pertama menjalankan LLM offline adalah memahami kemampuan perangkat yang tersedia. Kapasitas memori sistem, VRAM, unit pemrosesan, dan kapasitas disk akan mempengaruhi model yang nyaman dijalankan. Memilih model terlalu besar dapat membuat proses inferensi sangat lambat, sehingga model kompak layak diprioritaskan pada perangkat terbatas.
Ukuran LLM memang memiliki pengaruh terhadap kemampuan model, tetapi LLM terbesar belum tentu paling sesuai untuk seluruh jenis pekerjaan. LLM kompak yang telah dioptimalkan dapat memberikan hasil memadai pada pekerjaan ringan dengan kebutuhan komputasi lebih terjangkau. Cara seperti ini membuat TEKNOLOGI AI dapat dimanfaatkan tanpa perangkat mahal.

Model Terkuantisasi Membuat LLM Offline Lebih Ringan
Teknik pengurangan presisi menjadi pendekatan penting untuk mengurangi kebutuhan memori LLM. Representasi parameter yang lebih ringkas dapat membutuhkan ruang RAM lebih sedikit dibandingkan format model yang belum dikompresi. Keuntungan ini membuat quantization sangat berguna bagi pengguna laptop yang tidak memiliki RAM besar.
Memilih presisi model sebaiknya disesuaikan dengan kemampuan perangkat. Presisi yang semakin rendah dapat mengurangi kebutuhan resource, tetapi mungkin memberikan kompromi terhadap hasil. Untuk mendapatkan keseimbangan, pengguna dapat membandingkan format yang tersedia hingga menentukan konfigurasi yang sesuai. Pengaturan tersebut menjadi bagian penting TEKNOLOGI AI lokal.
Atur Context Window agar RAM dan VRAM Tidak Cepat Penuh
Panjang konteks sering kurang diperhatikan oleh pengguna pemula, padahal context yang panjang membutuhkan resource tambahan. Ketika percakapan menjadi semakin panjang, runtime perlu menyimpan state tambahan. Pada perangkat terbatas, penggunaan context window berlebihan dapat meningkatkan tekanan memori.
Jika kebutuhan hanya percakapan sederhana, panjang konteks secukupnya biasanya lebih masuk akal. Context length dapat dinaikkan ketika benar benar diperlukan daripada selalu mengaktifkan kapasitas terbesar. Pendekatan ini dapat mengurangi pemborosan resource sekaligus membuat penggunaan model lebih efisien.
Seimbangkan Pemrosesan CPU dan GPU untuk Performa Lebih Efisien
Pemroses grafis dapat membantu meningkatkan kecepatan generasi token apabila hardware memiliki dukungan yang diperlukan. Namun, VRAM yang terbatas membuat seluruh model tidak selalu dapat ditempatkan pada GPU. Dalam kondisi tersebut, pengguna dapat menggunakan konfigurasi offloading secara bertahap.
Besarnya GPU offloading dapat disesuaikan dengan kapasitas VRAM. Jika VRAM mencukupi, akselerasi grafis bisa dimanfaatkan lebih jauh. Sebaliknya, jika VRAM sangat terbatas, pemrosesan bisa lebih banyak menggunakan RAM sistem. Fleksibilitas tersebut membuat TEKNOLOGI LLM offline lebih mudah digunakan pada konfigurasi komputer berbeda.
Optimasi Sistem Membantu Menyisakan Memori untuk Model AI
Tidak hanya konfigurasi LLM, lingkungan eksekusi AI juga mempengaruhi penggunaan resource. Program latar belakang dapat menggunakan sebagian besar RAM. Saat perangkat memiliki kapasitas terbatas, mengurangi program background dapat memberikan ruang tambahan.
Aplikasi LLM lokal yang teroptimasi juga dapat membantu memanfaatkan hardware secara lebih baik. Konfigurasi GPU offloading, serta manajemen cache dapat disesuaikan berdasarkan perangkat. Tidak perlu mengaktifkan seluruh fitur sekaligus. Fokus utama adalah membuat TEKNOLOGI AI bekerja sesuai kemampuan hardware.
Kesimpulan, Optimasi yang Tepat Membuat AI Lokal Lebih Hemat Memori
Menjalankan LLM offline pada perangkat terbatas tetap memungkinkan selama pengguna memahami keterbatasan perangkat. Menggunakan LLM sesuai kapasitas hardware, menggunakan model terkuantisasi, menghindari context berlebihan, serta mengatur GPU offloading dapat membantu meningkatkan stabilitas.
Dalam perkembangan berikutnya, LLM berukuran ringkas berpotensi membawa kemampuan AI ke lebih banyak perangkat. Dari pengalaman Anda, apakah LLM berukuran kecil dan efisien akan menjadi alternatif menarik terhadap layanan berbasis cloud? Sampaikan pengalaman Anda mengenai perkembangan TEKNOLOGI kecerdasan buatan dan ikuti pembahasan berikutnya untuk memahami optimasi LLM dengan lebih baik.


